Лекция
Инженерия хаоса — это дисциплина экспериментирования над системой с целью повышения уверенности в способности системы выдерживать турбулентные условия в процессе производства.
В разработке программного обеспечения способность программы выдерживать сбои , обеспечивая при этом надлежащее качество обслуживания — часто называемая отказоустойчивостью — обычно указывается в качестве требования. Однако команды разработчиков могут не выполнить это требование из-за таких факторов, как сжатые сроки или недостаток знаний в предметной области. Хаос-инженерия включает в себя методы, направленные на выполнение требований к отказоустойчивости.
Инженерия хаоса может быть использована для достижения устойчивости к сбоям инфраструктуры , сбоям сети и сбоям приложений; последнее включает в себя устойчивость к необработанным исключениям .
Chaos Engineering напрямую проверяет:
Для оценки уровня уверенности в надежности взаимосвязанных сложных систем, внедряемых в производственную среду, необходимы показатели операционной готовности. Операционная готовность может быть оценена с помощью моделирования в рамках теории хаоса. Решения для повышения отказоустойчивости и операционной готовности платформы включают в себя усиление возможностей резервного копирования, восстановления, передачи файлов по сети, переключения при сбоях и общей безопасности среды.
Оценка, призванная вызвать хаос в среде Kubernetes , привела к завершению работы случайных подов, получающих данные от периферийных устройств в центрах обработки данных во время обработки аналитики в сети больших данных. Время восстановления подов было показателем отказоустойчивости, который оценивал время отклика.
1983 – Apple
Пока разрабатывались MacWrite и MacPaint для первого компьютера Apple Macintosh , Стив Кэппс создал «Обезьянку» — настольный аксессуар , который случайным образом генерировал события пользовательского интерфейса на высокой скорости, имитируя обезьяну, отчаянно стучащую по клавиатуре, двигающуюся и щелкающую мышью. Его быстро стали использовать для отладки , генерируя ошибки для исправления программистами, поскольку автоматическое тестирование было невозможно; у первого Macintosh было слишком мало свободного места в памяти для чего-либо более сложного.
1992 – Пролог. Пока разрабатывались ABAL2 и SING для первых графических версий операционной системы PROLOGUE, Иэн Джеймс Маршалл создал «La Matraque» — настольное устройство , которое на высокой скорости генерировало случайные последовательности как допустимых, так и недопустимых событий графического интерфейса , проверяя таким образом поведение критически важных графических библиотек на границах разделов. Эта программа запускалась перед поставкой в производство и работала несколько дней подряд, обеспечивая необходимую степень полной отказоустойчивости. Впоследствии этот инструмент был расширен, чтобы включить инструкции доступа к базам данных и другим файлам языка ABAL для проверки и обеспечения их последующей отказоустойчивости. Вариант этого инструмента в настоящее время используется для проверки современной версии, известной как OPENABAL.
2003 – Amazon
Работая над повышением надежности веб-сайтов в Amazon , Джесси Роббинс создал «День игры» — инициативу, которая повышает надежность за счет целенаправленного регулярного создания серьезных сбоев. Роббинс говорил, что вдохновился подготовкой пожарных и исследованиями в других областях, уроками по сложным системам и инженерии надежности .
2006 – Google
Работая в Google , Крипа Кришнан создал программу, аналогичную программе Amazon Game Day (см. выше), под названием "DiRT" (Disaster Recovery Testing). Джейсон Кахун, инженер по надежности сайтов в Google, написал главу о Google DiRT в книге "Chaos Engineering" и описал систему на конференции GOTOpia 2021.
2011 – Netflix
В 2011 году , курируя миграцию Netflix в облако, Нора Джонс, Кейси Розенталь и Грег Орзелл расширили эту дисциплину, работая вместе в Netflix, создав инструмент, который вызывал сбои в их производственной среде, используемой клиентами Netflix. Цель состояла в том, чтобы перейти от модели разработки, предполагающей отсутствие сбоев, к модели, где сбои считались неизбежными, побуждая разработчиков рассматривать встроенную отказоустойчивость как обязанность, а не как опцию:
«В Netflix наша культура свободы и ответственности привела к тому, что мы не заставляли инженеров проектировать свой код определенным образом. Вместо этого мы обнаружили, что можем объединить наши команды вокруг идеи отказоустойчивости инфраструктуры, изолируя проблемы, создаваемые нейтрализацией серверов, и доводя их до крайности. Мы создали Chaos Monkey — программу, которая случайным образом выбирает сервер и отключает его в обычные часы работы. Кому-то это покажется безумием, но мы не могли полагаться на случайное возникновение события для проверки нашего поведения перед лицом последствий этого события. Знание того, что это будет происходить часто, создало сильное взаимодействие среди инженеров для создания резервирования и автоматизации процессов, чтобы пережить подобные инциденты, не затрагивая миллионы пользователей Netflix. Chaos Monkey — один из наших наиболее эффективных инструментов для повышения качества наших услуг».
Регулярно "отключая" случайные экземпляры программного сервиса, можно было протестировать избыточную архитектуру и убедиться, что сбой сервера не оказывает заметного влияния на клиентов.
Концепция хаос-инженерии близка к концепции серверов Phoenix, впервые представленной Мартином Фаулером в 2012 году.
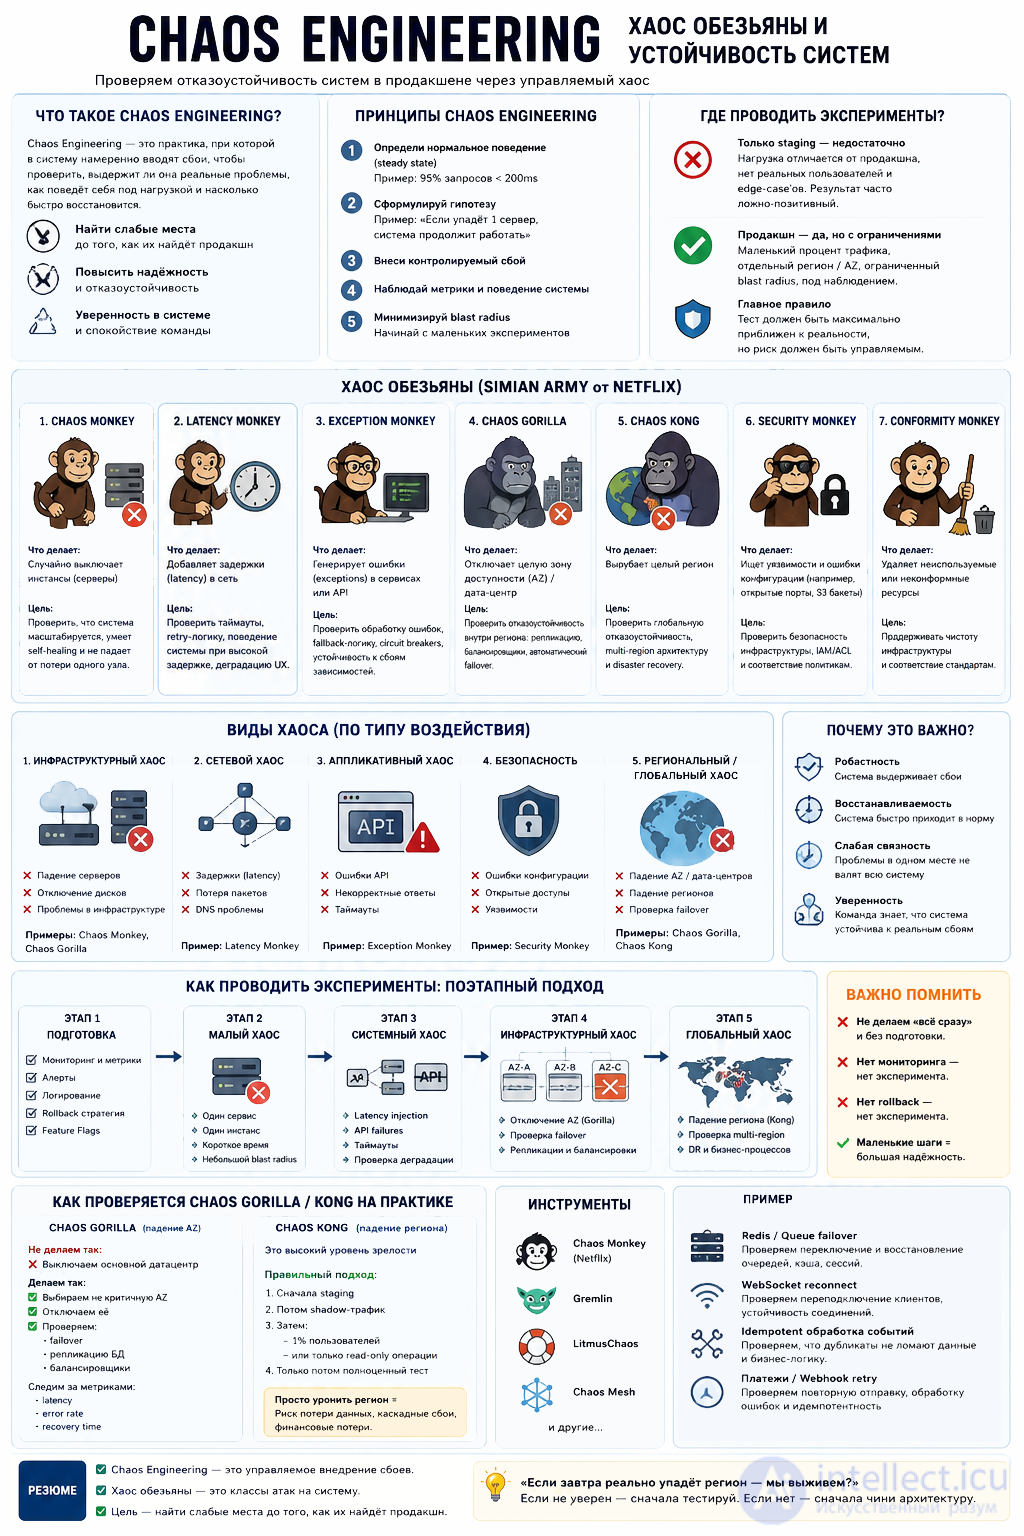
Chaos Monkey, Gorilla
Latency Monkey
Exception Monkey
Security Monkey
Kong / Gorilla
Хаос-инжиниринг ≠ случайный хаос
Это ближе к:
Например Chaos Kong / Chaos Gorilla в идеале проверяются на реальных продакшн-системах, но очень контролируемо и поэтапно.
Главное правило Chaos Engineering
Тест должен быть максимально приближен к реальности,
но риск должен быть управляемым
Chaos Kong (падение региона) Это уже очень высокий уровень зрелости
Реальный подход:
Chaos Monkey — это инструмент, разработанный Netflix в 2011 году для проверки устойчивости своей ИТ-инфраструктуры. Он работает путем преднамеренного отключения компьютеров в производственной сети Netflix, чтобы проверить, как оставшиеся системы реагируют на сбой. Chaos Monkey теперь является частью более крупного набора инструментов под названием Simian Army, предназначенного для моделирования и тестирования реакции на различные системные сбои и крайние случаи.
Код, лежащий в основе Chaos Monkey, был выпущен компанией Netflix в 2012 году под лицензией Apache 2.0.
Название «Обезьяна Хаоса» объясняется в книге Антонио Гарсиа Мартинеса «Обезьяны Хаоса »:
Представьте себе обезьяну, проникающую в «центр обработки данных» — эти «фермы» серверов, на которых размещаются все критически важные функции нашей онлайн-деятельности. Обезьяна беспорядочно рвет кабели, ломает устройства и возвращает все, что попадает ей в руки [то есть разбрасывает экскременты]. Задача ИТ-менеджеров — спроектировать информационную систему, за которую они отвечают, таким образом, чтобы она могла работать, несмотря на этих обезьян, ведь никто никогда не знает, когда они появятся и что они разрушат.
Что делает:
Случайно выключает инстансы (серверы)
Цель:
Проверить, что система:
«Армия обезьян» — это набор инструментов, разработанных Netflix для проверки надежности, безопасности или отказоустойчивости своей инфраструктуры Amazon Web Services , и включает в себя следующие инструменты:
Что делает:
Добавляет задержки (latency)
Цель:
Проверить:
Что делает:
Генерирует ошибки (exceptions)
Цель:
Что делает:
Отключает целый дата-центр / availability zone
Цель:
Проверка:
Что делает:
Вырубает целый регион
Цель:
Что делает:
Ищет уязвимости (например, открытые порты)
Цель:
Что делает:
Удаляет неиспользуемые ресурсы
Цель:
«День хаоса» Voyages-sncf.com в 2017 году превратил моделирование сбоев на этапе подготовки к производству в игру , что было представлено на конференции DevOps REX 2017 года. Компания Steadybit, основанная в 2019 году, популяризировала хаос на этапе подготовки к производству и инженерию надежности. Ее открытый Reliability Hub расширяет возможности Steadybit.
Proofdock может внедрять сбои инфраструктуры, платформы и приложений в Microsoft Azure DevOps . Gremlin — это платформа «сбой как услуга». Проект Storm от Facebook имитирует сбои центров обработки данных для повышения устойчивости к стихийным бедствиям.

Комментарии