Лекция 11 мин.
Привет, Вы узнаете о том , что такое record lock, Разберем основные их виды и особенности использования. Еще будет много подробных примеров и описаний. Для того чтобы лучше понимать что такое record lock, gap lock, next-key lock , настоятельно рекомендую прочитать все из категории Базы данных - MySql (Maria DB).
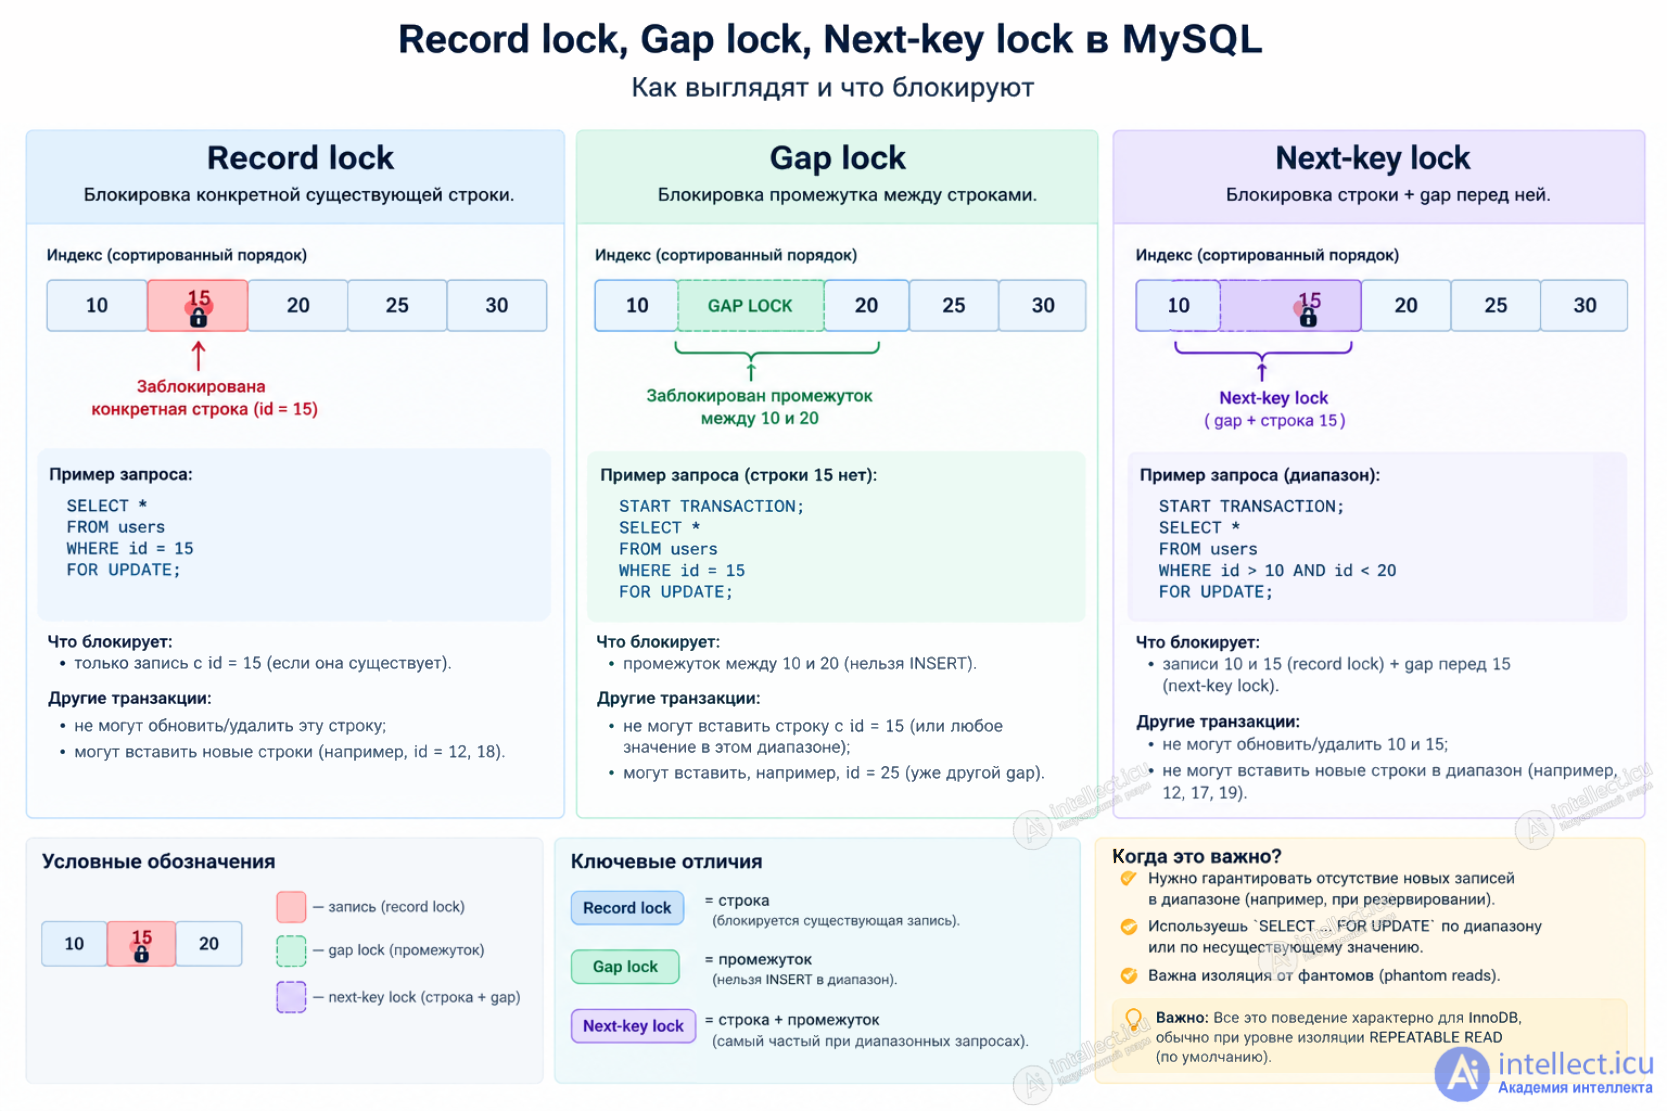
Gap lock в MySQL InnoDB — это блокировка не самой существующей строки, а промежутка между индексными значениями.
Главная цель — не дать другой транзакции вставить новую строку в этот промежуток.
Допустим, есть индекс:
id
---
10
20
30
Транзакция 1:
START TRANSACTION;

SELECT *
FROM users
WHERE id BETWEEN 10 AND 20
FOR UPDATE;
InnoDB может заблокировать не только строки 10 и 20, но и gap между ними:
10  [-----------]  20
     GAP LOCK
Теперь другая транзакция:
INSERT INTO users (id) VALUES (15);
может заблокироваться, потому что 15 попадает в заблокированный gap.
Представьте:
SELECT *
FROM users
WHERE id > 10 AND id < 20
FOR UPDATE;
В первой транзакции сейчас вообще нет подходящих строк.
Без gap lock вторая транзакция могла бы сделать:
INSERT INTO users (id) VALUES (15);
И после этого первая транзакция при повторном чтении внезапно увидела бы новую строку 15.
Это связано с проблемой phantom reads.
Gap lock позволяет InnoDB сказать:
«В этом диапазоне сейчас ничего нет — и пока я держу блокировку, не позволяй другим транзакциям вставить туда новые индексные записи».
Record lock:
10 [LOCK] 20
Блокируется конкретная существующая запись 10.
Gap lock:
10 [ GAP LOCK ] 20
Блокируется пространство между индексными записями — чтобы туда нельзя было вставить новую запись.
next-key lock — это комбинация:
GAP LOCK + RECORD LOCK
Именно next-key locks часто встречаются при SELECT ... FOR UPDATE и range-запросах в InnoDB.
Главное — gap lock не стоит использовать “на всякий случай”. Обычно его появление — следствие SELECT ... FOR UPDATE с диапазоном или определенного уровня изоляции.
Он нужен, когда тебе важно гарантировать не только:
«эту существующую запись никто не изменит»
но и:
«в этот диапазон никто не сможет вставить новую запись до окончания моей транзакции».
Типичный пример — резервирование диапазона.
Допустим, есть таблица:
orders
id
user_id
status
Вы проверяете:
SELECT *
FROM orders
WHERE user_id = 123
  AND status = 'pending'
FOR UPDATE;
Если вамнужно гарантировать, что между проверкой и вставкой другой transaction не создаст такую же запись, одного блокирования существующих строк может быть недостаточно.
Но часто это лучше решать уникальным индексом, а не gap lock.
SELECT ... WHERE id = 15 FOR UPDATE иногда ставит gap lock, даже когда строки 15 вообще не существует .Да — это как раз один из самых важных нюансов InnoDB. Разберем на конкретном примере.
Допустим:
CREATE TABLE users (
    id INT PRIMARY KEY,
    name VARCHAR(100)
) ENGINE=InnoDB;

INSERT INTO users VALUES
(10, 'Alice'),
(20, 'Bob');
Получаем индекс:
10              20
│                │
└────── gap ─────┘
START TRANSACTION;

SELECT *
FROM users
WHERE id = 15
FOR UPDATE;
Записи id = 15 не существует.
И вот тут возникает интересное:
InnoDB не может поставить record lock на 15, потому что такой записи нет.
Поэтому при REPEATABLE READ он может поставить gap lock на диапазон, куда попала бы запись 15:
10        [ GAP LOCK ]        20
           ↑
          15
То есть фактически:
«Строки 15 сейчас нет, но я запрещаю другой транзакции вставить 15 в этот диапазон».
Теперь другой connection:
START TRANSACTION;

INSERT INTO users (id, name)
VALUES (15, 'Charlie');
И он зависнет на блокировке.
Почему?
Потому что первая транзакция сказала:
10 ──────── X ──────── 20
           ↑
      нельзя INSERT
Вторая хочет вставить:
10 ──── 15 ──── 20
       ↑
     INSERT
А 15 находится внутри gap, который заблокирован.
После:
-- connection 1
COMMIT;
первая блокировка снимается, и второй INSERT сможет продолжить.
Представим, что gap lock не было бы.
Транзакция №1:
START TRANSACTION;

SELECT *
FROM users
WHERE id = 15
FOR UPDATE;
Получает:
ничего
Потом транзакция №2:
INSERT INTO users VALUES (15, 'Charlie');
COMMIT;
А транзакция №1 продолжает работать.
Получается неприятная ситуация:
T1: "15 не существует"
          ↓
T2: INSERT 15
          ↓
T1: "а теперь 15 существует"
Это один из вариантов phantom problem.
Поэтому InnoDB при REPEATABLE READ может заблокировать сам промежуток, а несуществующую строку.
id = 15 существует?Допустим:
10
15
20
И выполняем:
SELECT *
FROM users
WHERE id = 15
FOR UPDATE;
Теперь существует конкретная запись.
InnoDB может поставить record lock на 15:
10 [15 LOCKED] 20
И другой:
UPDATE users
SET name = 'X'
WHERE id = 15;
будет ждать.
Если запрос идет по PRIMARY KEY / UNIQUE index и ты делаешь точное равенство, поведение отличается от range scan.
Например:
WHERE id = 15
где id — PRIMARY KEY.
Если 15 существует → блокируется запись.
Если 15 не существует → в REPEATABLE READ InnoDB может блокировать соответствующий gap.
А если запрос:
WHERE id > 10 AND id < 20
то ситуация еще интереснее: здесь уже range locking, и InnoDB может использовать next-key locks — комбинацию record lock + gap lock.
              InnoDB index

      10          20          30
       │           │           │
       ▼           ▼           ▼
───────●───────────●───────────●──────
       ↑           ↑
       │           │
       └── gap ────┘
SELECT ... Об этом говорит сайт https://intellect.icu . WHERE id = 15 FOR UPDATE при отсутствии 15:
───────●═══════════●───────────●──────
      10   GAP     20
           LOCK
Поэтому:
INSERT INTO users(id) VALUES (15);
ждет.
А:
INSERT INTO users(id) VALUES (25);
не должен ждать из-за этого конкретного gap lock, потому что 25 находится уже в другом диапазоне.
И вот здесь появляется очень практический вывод: если ты видишь Lock wait timeout на INSERT, хотя никто вроде бы не блокировал строку с таким id, вполне возможно, что ее вообще не существует — и ее блокирует gap lock другой транзакции.
Это очень важно.
Например:
SELECT *
FROM orders
WHERE user_id = 123
FOR UPDATE;
Если user_id нормально индексирован, InnoDB блокирует гораздо более узкий диапазон.
Без подходящего индекса ситуация может быть значительно хуже: InnoDB может просматривать и блокировать большое количество индексных записей.
Поэтому первое правило:
Проверяй
EXPLAINи индексы для запросов, которые выполняютсяFOR UPDATE.
Например:
SELECT *
FROM users
WHERE id = 123
FOR UPDATE;
где:
id PRIMARY KEY
Это намного лучше, чем:
SELECT *
FROM users
WHERE id > 100 AND id < 200
FOR UPDATE;
В первом случае тебе нужна конкретная запись.
Во втором ты говоришь базе:
«Заблокируй диапазон».
И тут уже появляются next-key/gap locks.
Очень важное правило.
Плохо:
START TRANSACTION;

SELECT ... FOR UPDATE;

-- HTTP request
-- обращение к API
-- расчеты
-- пользователь что-то делает
-- 10 секунд...

UPDATE ...;

COMMIT;
Все это время lock живет.
Лучше:
START TRANSACTION;

SELECT ... FOR UPDATE;

UPDATE ...;

COMMIT;
То есть критическая секция должна быть максимально короткой.
FOR UPDATEНапример, если ты делаешь:
SELECT balance
FROM accounts
WHERE id = 123
FOR UPDATE;
только для того, чтобы потом:
UPDATE accounts
SET balance = balance - 100
WHERE id = 123;
можно часто сделать атомарный UPDATE:
UPDATE accounts
SET balance = balance - 100
WHERE id = 123
  AND balance >= 100;
А затем проверить:
affected_rows == 1
Это зачастую проще и уменьшает количество ручных блокировок.
Допустим, задача:
У пользователя может быть только один активный subscription.
Не обязательно делать:
SELECT ... FOR UPDATE;
-- проверка
-- INSERT
Лучше, если модель данных позволяет, обеспечить это ограничением:
UNIQUE (...)
и обрабатывать конфликт вставки.
Ограничения БД часто лучше ручных блокировок.
Хороший пример — очередь/резервирование диапазона, когда тебе нужно атомарно:
То есть тебе действительно нужна гарантия:
[----------- ЗАЩИЩЁННЫЙ ДИАПАЗОН -----------]
А не просто:
[LOCK] конкретной строки
Gap locks особенно связаны с REPEATABLE READ, который является стандартным isolation level для InnoDB.
Можно использовать:
SET TRANSACTION ISOLATION LEVEL READ COMMITTED;
В READ COMMITTED InnoDB значительно меньше использует gap locking для обычных поисковых операций, хотя некоторые gap locks все равно остаются, например связанные с проверками уникальности и внешними ключами.
Поэтому переключать весь проект на READ COMMITTED только ради избавления от gap locks я бы не советовал. Сначала нужно понять, зачем именно возникла блокировка.
Я бы держал в голове такую последовательность:
Нужно защитить существующую строку?
        ↓
SELECT ... FOR UPDATE
по PRIMARY KEY / UNIQUE INDEX
        ↓
Да → row/record lock

Нужно запретить INSERT в диапазон?
        ↓
Нужна range locking семантика
        ↓
gap/next-key lock оправдан

Нужно просто не допустить дубликат?
        ↓
UNIQUE INDEX предпочтительнее lock

Можно выполнить изменение одним UPDATE?
        ↓
Атомарный UPDATE предпочтительнее SELECT FOR UPDATE
И самое главное: gap lock сам по себе не проблема. Проблема возникает, когда приложение неожиданно блокирует большой диапазон и из-за этого другие транзакции начинают ждать.
Исследование, описанное в статье про record lock, подчеркивает ее значимость в современном мире. Надеюсь, что теперь ты понял что такое record lock, gap lock, next-key lock и для чего все это нужно, а если не понял, или есть замечания, то не стесняйся, пиши или спрашивай в комментариях, с удовольствием отвечу. Для того чтобы глубже понять настоятельно рекомендую изучить всю информацию из категории Базы данных - MySql (Maria DB)

Комментарии