Лекция 6 мин.
Привет, Вы узнаете о том , что такое Что Take Redis?, Разберем основные их виды и особенности использования. Еще будет много подробных примеров и описаний. Для того чтобы лучше понимать что такое Что Take Redis? , настоятельно рекомендую прочитать все из категории Базы данных - Redis DB Nosql.
Redis (расшифровывается sik Remote Dictionary Server) – это быстрое
хранилище данных типа «ключ-значение» в памяти 3 открытым
исходным кодом для использования в качестве базы данных, кэша,
брокер сообщений или очереди.
Redis обеспечивает время отклика на уровне доли миллисекунды
приложениям, работающим в режиме реального времени, выполнять
миллионы запросов в секунду. Такие приложения востребованы в сфере игр,
рекламных технологий, финансовых сервисов, здравоохранения .
Redis широко применяется для кэширования, управления сеансами,
разработки игр, создание таблиц лидеров, аналитики в режиме
реального времени, работы с геопространственными данными, поддержки служб
такси, чатов и сервисов обмена сообщениями, потоковой передачи.
мультимедиа и приложений с отправкой сообщений по модели
«издатель – подписчик» (Pub/Sub).
По сути, Redis — это большая распределенная hash-таблица, где в качестве ключа используется произвольная строка, а в качестве значения — одна из поддерживаемых структур данных (строки, списки, хеш-таблицы, set, отсортированные set и т.д.). Вкратце пробежимся по характеристикам:
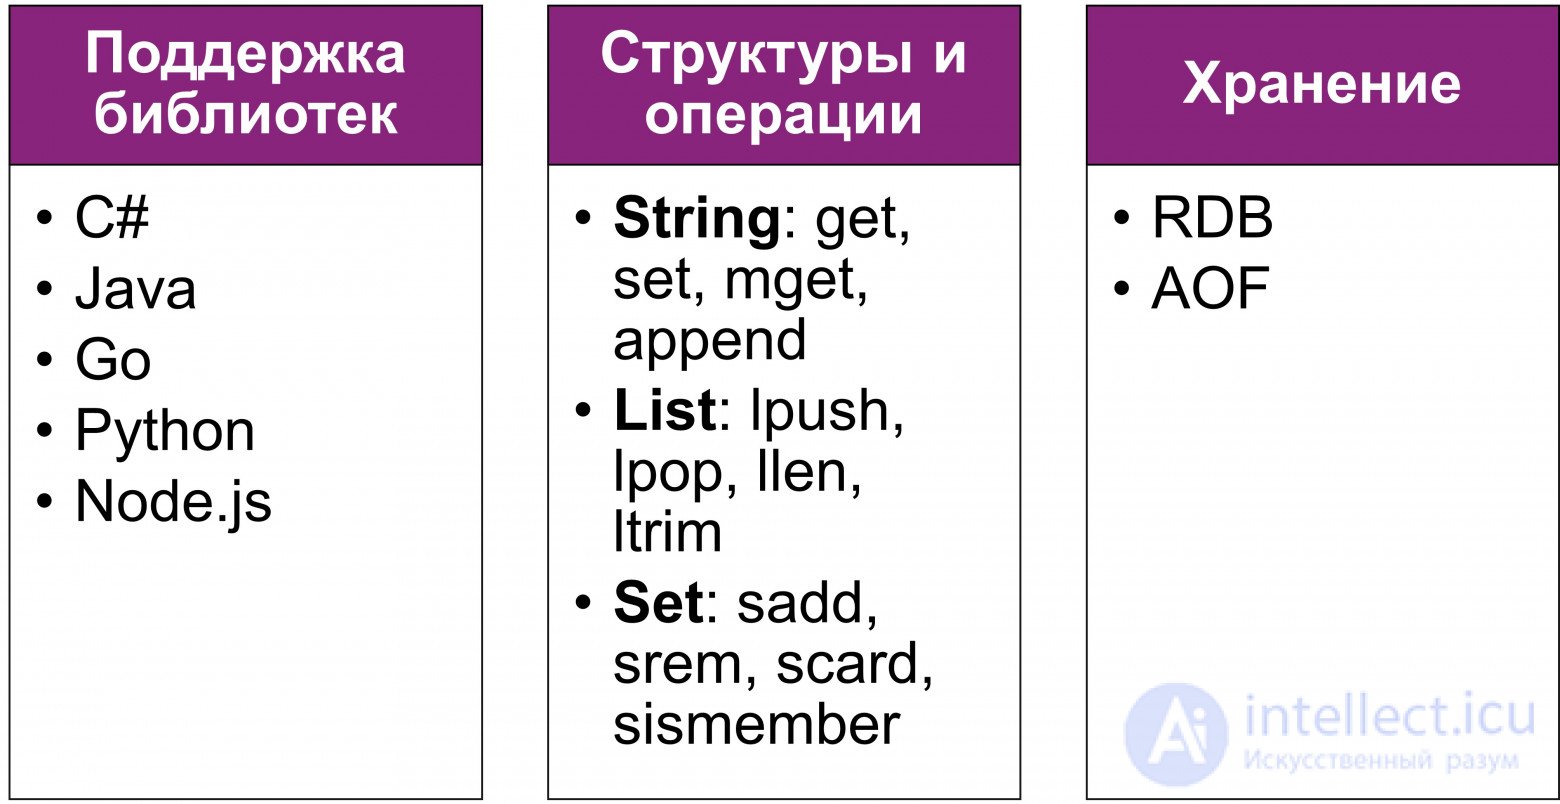
Персистентность: есть два режима хранения — RDB и AOF.
Поддержка отказоустойчивости в различных топологиях на все случаи жизни и под любые задачи.
Информационная безопасность: контроль доступа и шифрование данных.
Configuration management и мониторинг.
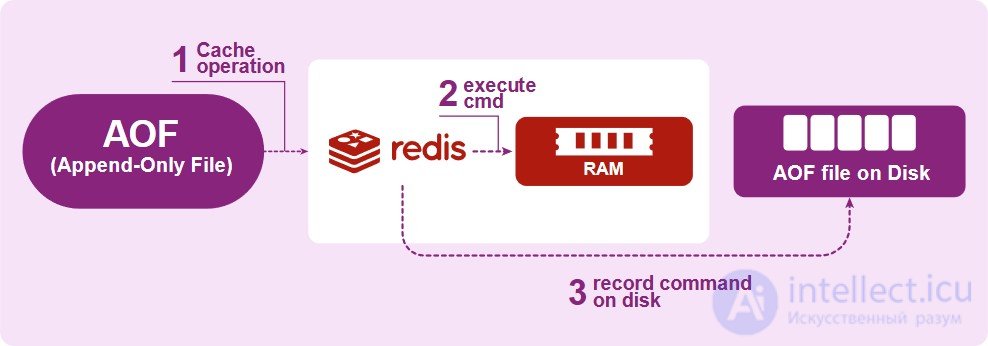
Персистентность — важный аспект, который нужно рассмотреть поподробнее. Redis поддерживает два режима хранения — RDB и AOF.
AOF (append only file) реализует журнал операций, где все новые операции просто дописываются в конец файла. Этот файл человекочитаемый, то есть его вполне можно читать и даже редактировать. В отличие от RDB, AOF не блокирует Redis.
У этого режима есть и недостатки: например, постепенный рост журнала. Но для решения этой проблемы предусмотрена его компактификация — AOF Rewrite. Об этом говорит сайт https://intellect.icu . Когда файл чересчур разрастается, Redis запускает AOF Rewrite и схлопывает некоторые команды. Например, если мы инкрементировали счетчик пять раз, то вместо пяти команд после работы алгоритма останется всего одна.
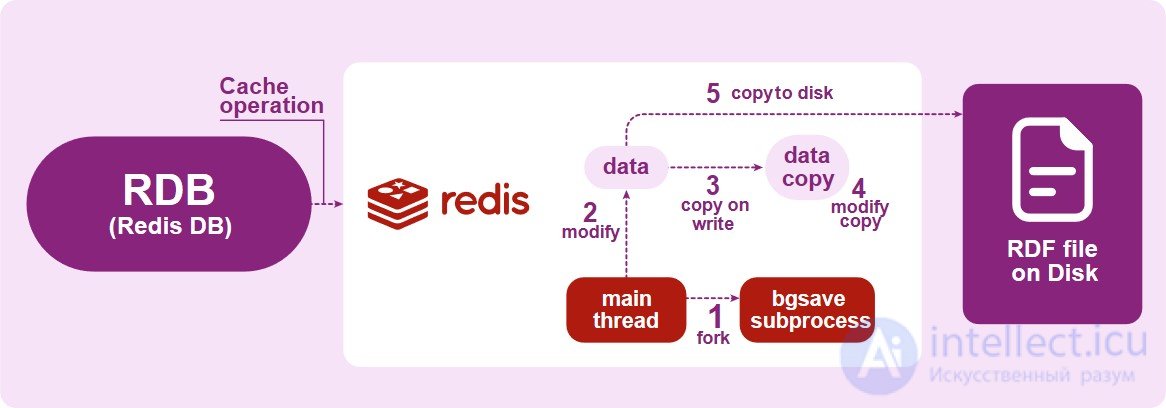
RDB (Redis database) периодически сохраняет снэпшот всего dataset. Для этого выполняется fork основного процесса и запускается процедура записи снэпшота — BGSAVE. По этой причине для сохранения снэпшота при интенсивном изменении данных в самом общем случае потребуется двойной объем оперативной памяти от размера dataset.
Конечно, в современном ядре ОС есть режим Copy-on-Write, но он сработает только при невысокой интенсивности изменений данных в оперативной памяти. А если мы говорим о сотнях, миллионах и миллиардах ключей, то это очень существенные объемы.
RDB, в отличие от AOF, приводит к блокировкам и не рекомендуется к использованию на мастер-узлах.
Один узел или stand-alone. Самая простая топология. Имеет право на существование, но исключительно для сред разработки и тестирования, поскольку не является отказоустойчивой.

Master-Replica (Secondary). В такой топологии между мастером и репликой происходит постоянная асинхронная репликация. Для принудительной синхронизации, то есть для перехода на синхронный режим, в Redis есть специальная команда WAIT.
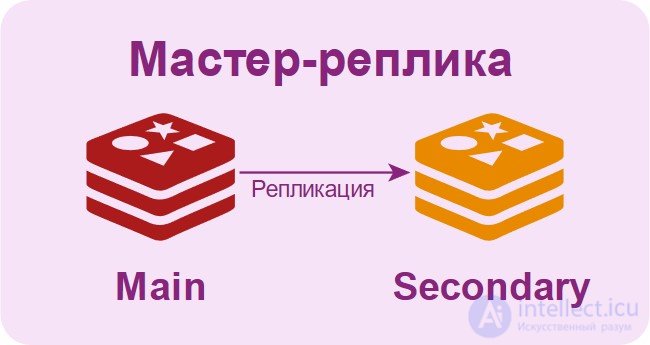
Sentinel. Эта топология развертывания широко применялась на ранних версиях Redis, до поддержки полноценного кластера. Она состоит из отдельных специальных узлов, которые мониторят работу основных узлов Redis, отслеживают сбои Master и запускают процесс восстановления. Работает поверх топологии Master-Replica.

Полноценный кластер, который состоит из набора мастер-узлов и набора реплик (secondary-узлы). Для репликации используется протокол Gossip: распространение информации в нем идет способом, похожим на эпидемию — каждый узел передает информацию известным ему «соседям». Клиенты могут работать как с мастером, так и с репликой, но с реплики идет только чтение.

Данные в кластере шардированы, то есть разбиты на сегменты. Кластер не использует консистентное хеширование, вместо этого используются так называемые хеш-слоты.
Всего кластер имеет 16384 слота. Для вычисления хеш-слота для ключа используется формула crc16(key) % 16384.
Каждый узел Redis отвечает за конкретное подмножество хеш-слотов. Например:
Узел A содержит хеш-слоты от 0 до 5500.
Узел B содержит хеш-слоты от 5501 до 11001.
Узел C содержит хеш-слоты от 11001 до 16383.
Это позволяет легко добавлять и удалять узлы кластера, то есть осуществлять быстрый решардинг.
Redis поддерживает огромное количество структур данных. Основные — это, конечно же, string, list, hash, table и set. Для работы с каждой из них есть набор операций: со строками мы работаем с помощью get, mget, set, append, со списками используем lpush, lpop, ltrim, llen. Операций и структур данных так много, что описать их все в этой статье просто невозможно. Поэтому я предлагаю рассмотреть только специфичные типы данных: Sorted Set, Bitmap, HyperLogLog, Stream.
Sorted Set. На базе этой структуры можно построить уже знакомый нам алгоритм «скользящего окна» (Rate Limiter):
Для скоринга можно использовать timestamp входящего запроса.
Удалить устаревшие элементы, которые вышли за пределы окна, можно командой ZREMRANGEBYSCORE.
Количество запросов в окне вычисляется с помощью команды ZCARD.
Если количество запросов не превышает лимит, то новый запрос в окно можно добавить командой ZADD.
Исследование, описанное в статье про Что Take Redis?, подчеркивает ее значимость в современном мире. Надеюсь, что теперь ты понял что такое Что Take Redis? и для чего все это нужно, а если не понял, или есть замечания, то не стесняйся, пиши или спрашивай в комментариях, с удовольствием отвечу. Для того чтобы глубже понять настоятельно рекомендую изучить всю информацию из категории Базы данных - Redis DB Nosql

Комментарии